こんにちは、kickflow QAチームの川村です。
kickflowではおよそ1,200件のE2EテストをPlaywrightで実装し、深夜のnightly CIで並列実行しています。
テストの数が増えてくると、今度は「テストそのものの不安定さ」と「CIの実行時間」が開発のボトルネックになってきます。
実際、ある時点でメインのCIワークフローは直近30日で67.9%が失敗し、実行時間は通常50〜70分・最長180分と大きくばらついていました。
この記事では、E2Eテストの安定化(flaky削減)と高速化(CI時間短縮)を、まず計測の仕組みを整えてから段階的に進めた取り組みを紹介します。
課題:リトライで隠れていた不安定さ
まず、当時のCIの実態を数値で整理しました。
| 指標 | 実態 |
|---|---|
| メインワークフローの失敗率 | 直近30日で56回中38回失敗(67.9%) |
| retryワークフローの失敗率 | 200回中105回失敗(52.5%) |
| 実行時間 | 通常50〜70分、最長180分 |
retryワークフローが常時発動し、それでも収束していない状態です。
テストは通ったり落ちたりを繰り返しており、リトライによって表面上は緑に見えても、その下に大量の不安定さが隠れていました。
テストコード側にも定量的な問題がありました。
| 問題 | 規模 |
|---|---|
waitForTimeout() による固定待ち |
6,637件(spec 579ファイル+Page Object 199ファイルに分散) |
| テストデータ準備がUI操作 | 全体の約9割(API経由は約200件) |
force: true クリック |
85件 |
固定待ちを合算すると、フル実行1回あたり約2.8時間分のsleepがテストコードに内在していました。
実行基盤(シャード分配・認証キャッシュ・失敗時のみtrace取得)は整備済みだったため、伸びしろはテストコード側に集中していると判断しました。
flaky(フレーキー)テスト とは、コードを変えていないのに実行するたびに成功したり失敗したりする不安定なテストのことです。
リトライで最終的に通ってしまうため見過ごされがちですが、CIの信頼性と実行時間をじわじわと蝕みます。
方針:計測してから直す
やみくもに固定待ちを消したり並列数を増やしたりしても、効果は測れず、かえって回帰を生みます。
そこで、次の4段階で進める方針を立てました。
- 計測 — flakyを可視化し、対策の優先順位と効果測定の基盤を作る
- 流入防止 —
waitForTimeoutの新規追加をブロックし、これ以上悪化させない - 削減 — 影響の大きい要因から固定待ちや不安定要素を条件待ちに置換する
- 高速化 — テストデータ準備のAPI化、CI基盤の固定コスト削減
ポイントは、最初に「計測」を置いたことです。
見張り役を立てて全体の状況を把握してから対策に集中する、という順番を徹底しました。
フェーズ1:まず測る
flakyを可視化するカスタムレポーター
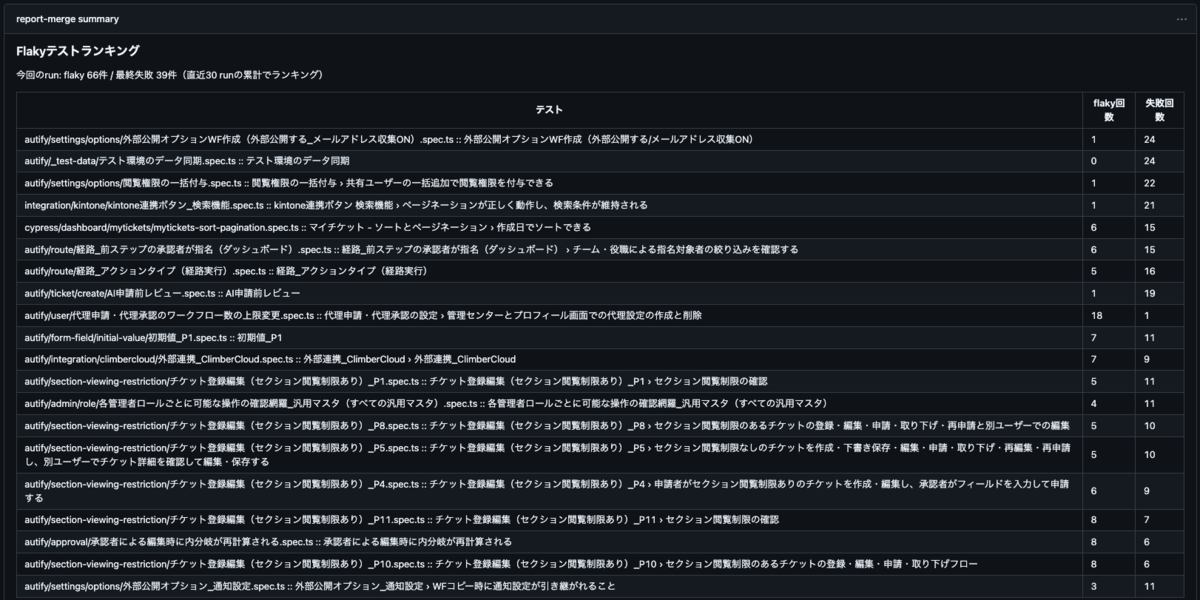
Playwrightのレポーターインタフェースを実装し、「リトライで通ったテスト(=flaky)」をシャードごとに記録するようにしました。
各シャードの結果をCIのマージジョブで集約し、GitHub ActionsのSummaryに常習犯ランキングとして表示します。
さらに履歴を蓄積することで、「どのテストが何回に1回落ちるか」を継続的に追えるようにしました。
これを最初のフル実行に適用したところ、リトライで隠れていた不安定さが初めて数値になりました。
- flaky 114件 / 最終失敗 26件
この記事では失敗を2つの用語で区別します。
flaky はリトライで最終的に成功した不安定なテスト数、最終失敗(failed) はリトライを使い切っても失敗したままのテスト数です。
どちらも分母は「nightlyフル実行1回」で、以降の数値もこの定義で統一しています。
「なんとなく不安定」だったものが、はっきりと114件という数字になった時点で、対策の起点ができました。
waitForTimeoutラチェットで流入を止める
削減と並行して重要なのが、これ以上固定待ちを増やさないことです。
そこで、ファイル単位で waitForTimeout の件数をベースラインとして記録し、増加したらCIを失敗させる「ラチェット」チェックを導入しました。
ラチェット(ratchet) とは、一方向にしか回らない歯車のことです。
ここでは「既存の固定待ちは許容するが、新規追加は許さない(数は減る方向にしか動かない)」という仕組みを指します。
// scripts/check-wait-ratchet.js の考え方
// ベースライン(許容件数)を超えたファイルだけを検出する
for (const [file, count] of Object.entries(currentCounts)) {
  const baseline = baselineCounts[file] ?? 0
  if (count > baseline) {
    violations.push({ file, baseline, current: count })
  }
}
固定待ちを削減するたびにベースラインを更新していくため、数は減る方向にしか動きません。
これで「知らないうちに元に戻る」事態を防ぎつつ、安心して削減を進められる土台ができました。
フェーズ2:flakyを削減する
最大の要因は個々のテストではなく共有ログインヘルパー
初回フル実行のflaky 114件と最終失敗 26件を合わせた140件の失敗を、要因ごとに分類したところ、意外な事実がわかりました。
| 要因 | 件数 |
|---|---|
| ログイン経路 | 81件 |
| スクリーンショット比較 | 13件 |
| テキスト不一致・タイムアウト | 10件 |
| その他(click/visible待ち等) | 36件 |
ログイン経路の81件は、flaky 114件の71%に相当します。
flakyの最大要因は特定のテストではなく、全テストが共有するログインヘルパーでした。
CIの集中負荷時に認証画面の描画が遅延し、ログイン後のリダイレクトが停滞することが原因です。
そこで、ログイン失敗時にフロー全体を再試行するよう強化しました。
その結果、flakyは114→73件(-36%)、ログイン起因は81件→約3件まで減少しました。
1か所を直すだけで、全体の3割以上のflakyが消えたことになります。
「決定論的な失敗」をflakyと誤認しない
flakyを潰していく中で、最も学びが大きかったのがデータ汚染スパイラルという失敗パターンです。
一例として、ビュー管理のテストは『作成・編集・削除』間でデータを受け渡す直列的な作りになっていました。
CI負荷でたまたま1回「削除」が失敗すると、残骸のデータが残ります。
すると次の実行では、その残骸のせいで「編集」や「削除」がさらに失敗し、残骸が累積していくという負のスパイラルに陥ります。
これは一見flakyに見えますが、実際には決定論的な失敗です。
クリーンな状態では現在のコードで全テストが通るのに、一度汚れると自力では回復できません。
リトライを重ねても直らないため、flakyとして片付けると永遠に解決しません。
対策は、テストを冪等(べきとう)に設計し直すことです。
冪等(idempotent) とは、同じ操作を何回繰り返しても結果が同じになる性質のことです。
テストの場合、「実行前の状態がどうであれ、毎回同じ結果になる」ように設計することを指します。
具体的には、テストの先頭で既存データを全削除してクリーンな状態を保証し、テスト全体を直列実行にしました。
これで、前回の実行が何を残していても、毎回まっさらな状態からスタートできます。
なお、この「先頭クリーンアップ+ファイル内の直列化」で防げるのは、同じファイル内での作成・削除の受け渡しによる汚染です。
複数のシャードが同じテナントを同時に操作する場合の競合は別の問題で、こちらはテナントを分けるなどの負荷分散が必要になります(後述の「同時負荷」の話につながります)。
同じパターンは役職管理のテストでも見つかりました。
こちらは「保存しました」という自動的に消えるトースト通知を待っていたことが発端でした。
// 消えやすいトースト待ちだと、取りこぼして誤判定することがある
// Before: 成功トーストの表示を待つ
await expect(page.getByText('保存しました')).toBeVisible()

// After: ダイアログのクローズ(=入力欄の消滅)を同期ポイントにし、
//        保存結果そのものは直後にテーブル上の役職の存在で検証する
await expect(page.getByRole('textbox', { name: '役職名' })).toBeHidden()
await expect(page.getByRole('cell', { name: '新しい役職' })).toBeVisible()
ポイントは、ダイアログのクローズを「保存が完了した合図」としてだけ使い、保存が成功したかどうかは直後にテーブル上に役職が存在することで検証している点です。
トーストを取りこぼすと保存成功を「失敗」と誤判定し、後続のクリーンアップに到達しません。
すると残骸の役職が残り、役職レベルが一意という制約に引っかかって、以降の作成が全て失敗する、やはり同じスパイラルでした。
待機対象を「消えやすいトースト」から「確実に消えるダイアログ+テーブルの実データ」へ変えることで根治しました。
この一連の経験から得た教訓は、「全部フレーキー」と決めつけず、失敗の性質を切り分けることの重要性です。
決定論的な失敗はテスト設計で根治でき、真のflakyは負荷対策で吸収する。両者を混同すると、どちらも直りません。
force: true は本当に必要か精査する
force: true は、Playwrightが本来行う要素のチェック(可視・安定・有効・他要素に覆われていないか)を握りつぶすオプションです。
便利な一方で、実在するオーバーレイの被覆バグやボタンの無効化を見逃すリスクがあります。
そこで、全85件(実コード77件+コメント内の表記8件)を1件ずつ精査し、7カテゴリに分類しました。
最も危険だったのは、toBeVisible と toBeEnabled で「見えていて押せる」ことを確認した直後に force: true で押している矛盾したコードです。
これは被覆・無効化バグを握りつぶす恐れがあるため、優先して除去しました。
一方で、残りの多くは外すと本当に壊れる正当なforceでした。
たとえばUIコンポーネントライブラリの一部要素は、内部の入力レイヤーがクリックを横取りする作りになっており、force を外すと確実に失敗します。
<div class="v-field__input"> intercepts pointer events
実際にforceを外して実行し、上記のエラーで失敗することを確認して「force必須」と結論づけました。
最終的に、安全に除去できたのは8件で、残りは正当と実証。
今後の歯止めとして、新規の force: true には理由コメントを必須とする運用にしました。
こうした削減作業では、CIだけを頼りにすると危険だという学びもありました。
CIは共有テナントが空の状態だと固定待ちを消しても素通りしてしまい、「偽の緑(false-green)」を出すことがあります。
そのため、ローカルで実ログインして緑にしてからCIに上げる手順を徹底し、CIでは見えない潜在的なflakyを何件も炙り出して根治できました。
フェーズ3:高速化する
安定化と並行して、CIの実行時間そのものにも手を入れました。
まず失敗のリトライ空振りを削る
深夜のフル実行が1時間8分かかった回を調査したところ、原因は並列分配の偏りではありませんでした。
30シャードの所要時間は中央値およそ35分で、シャードバランシング自体はほぼ理想どおりでした。
真因は、失敗テストのリトライ空振りが最遅シャードを膨張させていたことです。
あるファイルが丸ごと壊れると、全テストが同じ理由で失敗し、リトライのたびに同じ時間を空費します。
実行時間ベースの分配は「過去に成功したときの軽い時間」でそのファイルを配置するため、失敗時の膨張は計上されません。
対策として、リトライ回数を 2→1 に減らしました。
ファイル丸ごと壊れているテストは何回リトライしても同じ理由で落ちるため、3倍の空費が発生します。
flakyの検知は「1回目失敗→2回目成功」でも機能するため、検知能力を保ったまま空費を半減できます。
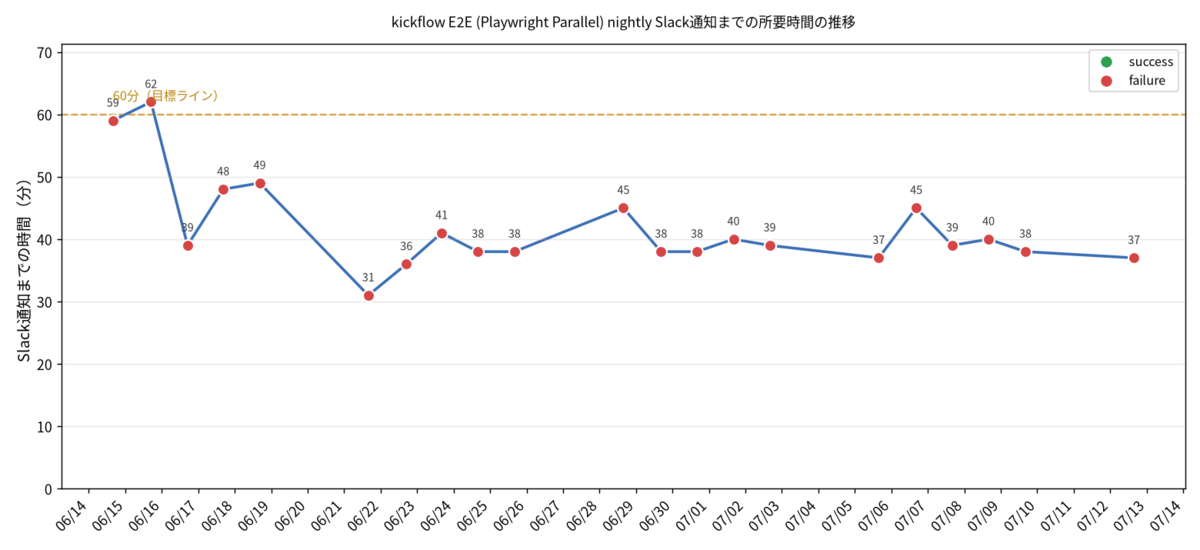
これに前述のデータ汚染スパイラルの根治を合わせ、全体の実行時間が1時間8分→47分に短縮されました。
固定コストをマネージドランナーで削る
次に着目したのが、各シャードにかかる固定オーバーヘッドです。
チェックアウト・依存パッケージのインストール・ブラウザのインストールといった準備工程が、30シャード分重複していました。
当初は「並列数を30→40に増やせば速くなるか」を検討しましたが、シャードを増やすほどこの固定費の重複も増えるため、まず固定費そのものを削る方針に切り替えました。
具体的には、nightlyの並列E2Eを組織標準のマネージドランナー(Blacksmith)へ切り替え、あわせてブラウザのキャッシュキーを解決済みのPlaywrightバージョン基準に統一しました。
キャッシュキーは従来 yarn.lock のハッシュを使っていたため、依存更新のたびに変わり、毎晩30シャード全てがキャッシュミスしてブラウザを再インストールしていました。
ブラウザのバイナリはPlaywrightのバージョンで決まるので、バージョンを基準にすることでこのミスを解消できます。
| 1シャードあたりの固定費 | 従来(毎晩コールド) | 切替後(定常) |
|---|---|---|
| 固定費合計 | 162秒(中央値・74〜585秒とばらつき) | 約40秒 |
| うちブラウザインストール | 60〜120秒 | 約9秒 |
固定費が約4倍速になり、全体時間も47分→38分に短縮されました。
高速化がflakyを増やすという逆説
ところが、この高速化には思わぬ副作用がありました。
切替後の初回nightlyで、最終失敗(failed)が普段の約3.7倍(15→56件)に増加したのです。
ここでの「15件」は、この時期のマネージドランナー切替前(ubuntu基盤)の定常nightlyでの平常値です。
フル実行をもう1回回しても再現したため、一過性のノイズではありません。
原因は、まさに高速化そのものでした。
各シャードの固定費は従来74〜585秒とシャードごとに大きくばらついており(幅にしておよそ500秒)、この不均一さが結果的に開始タイミングを自然に分散させていました。
それが切替後は均一な約40秒に収束したため、30シャードがほぼ同時(20〜35秒以内)にテストを開始するようになりました。
すると共有テナントへのログイン後リクエストが一斉に立ち上がり、バックエンドがスパイク負荷を受けて、各所の待機処理が制限時間を超過します。
失敗率をテナントの共有度で分析すると、単独テナントが5.9%なのに対し、共有度6以上のテナントは11〜12%と、明確に共有度に比例していました。
つまり、これはログイン渋滞でもIPブロックでもなく、同時負荷がボトルネックでした。
意図的にばらけさせる
同時負荷が原因である以上、タイムアウトやリトライ回数を増やしても解決しません。
実際、失敗は2回連続で100%が「全試行失敗」だったため、リトライ増はむしろ実行時間と同時負荷を増やして逆効果です。
そこで、シャードの開始タイミングを意図的にばらけさせることにしました。
シャード番号に比例した待機(ジッター)を入れ、その係数を拡大して、かつて自然に存在していた分散を人工的に復元します。
# シャード番号に比例した起動ジッターで一斉開始を緩和する
# 係数を ×3秒 → ×18秒 に拡大(30シャードで最大 ~522秒 ≒ 従来の自然分散)
- name: Stagger shard start
  run: sleep $(( SHARD_INDEX * 18 ))
ジッター(jitter) とは、意図的に加える時間的なばらつきのことです。
多数の処理が同じ瞬間に集中して負荷スパイクを起こすのを防ぐために、あえて開始時刻をずらします。
この係数拡大により、最終失敗(failed)は56→36件(約40%減)、特に負荷が集中していたテナントでは失敗が16→6件へと劇的に改善しました。
全体時間はジッター分だけ増えて43分になりましたが、高速化前の47分と比べれば利得は維持できています。
高速化して固定費を均一にしたら、今度はそれを少しだけ崩して負荷を分散する。
一見すると矛盾していますが、「全体を速くしつつ、開始タイミングだけはばらす」という調整が、この規模のテストスイートには必要でした。
成果
一連の取り組みの結果を、安定化と高速化の両面で整理します。
この表の「改善後」は、マネージドランナーへ切り替える前(ubuntu基盤・安定化フェーズ完了時点)の値です。
| 指標 | 改善前 | 改善後(ubuntu基盤) |
|---|---|---|
| flaky件数 | 114件 | 約73件 |
| うちログイン起因 | 81件 | 約3件 |
| 最終失敗件数(failed) | 26件 | 6件 |
flakyも最終失敗も、実行回や基盤の条件によって変動します。
flaky はログイン起因の解消直後でおよそ73件、高速化(マネージドランナー切替)直後は同時負荷で一時的に75件まで増加し、起動ジッター調整を経て52件に収束しました。
最終失敗(failed) も同様に、安定化フェーズ完了時点(ubuntu基盤)で6件だったものが、高速化フェーズでは切替直後に56件へ増加し、起動ジッター調整後は36件です(ubuntu基準の15件よりは多く、テナント負荷分散が次の課題として残っています)。
いずれも各回のnightlyフル実行での実測値です。
高速化
| 指標 | 改善前 | 改善後 |
|---|---|---|
| nightly全体の実行時間 | 1時間8分 | 43分 |
| 1シャードあたりの固定費 | 162秒 | 約40秒 |
| リトライ空振りによる膨張 | 最遅シャードで+27分 | 解消 |
数値以上に大きかったのは、計測の仕組みが残ったことです。
flakyの件数と常習ランキングが毎晩自動で記録され、固定待ちの件数はラチェットで増加が止まっています。
これにより、今後のテスト追加でも不安定さと固定待ちがじわじわ増える事態を防げます。
今後の展望
対策の多くは道半ばで、以下を継続しています。
- 固定待ちの条件待ち化: 影響の大きいPage Objectから、1件ずつ固有の条件待ちへ置換する
- テストデータ準備のAPI化: UI操作で作っているテストデータをAPI経由に置き換え、準備時間を削減する
- 共有テナントの負荷分散: 同時負荷の根本対策として、負荷が集中するテナントをクローンして分散する
まとめ
E2Eテストの安定化と高速化は、どちらも「まず計測してから直す」ことで着実に進められました。
flakyを可視化し、ラチェットで悪化を止めてから削減に入ることで、対策の効果を数値で確認しながら進められます。
特に印象的だったのは、次の2つの学びです。
1つは、決定論的な失敗をflakyと誤認しないこと。データ汚染スパイラルはリトライでは直らず、テストを冪等に設計し直すことで根治しました。
もう1つは、高速化が新たな不安定さを生むこと。固定費を均一化すると負荷が同期化するため、ジッターで意図的にばらす調整が必要でした。
同様の課題を抱えているプロジェクトの参考になれば幸いです。
kickflowのQAチームでは、テスト自動化の効率化だけでなく、品質保証プロセス全体の改善に取り組んでいます。
テストの高速化・安定化を通じてプロダクト開発の生産性向上に貢献し、品質と開発速度の両立を実現することがQAチームの重要なミッションだと考えています。
品質保証の技術的な課題解決に興味がある方、一緒にkickflowの品質を支えていただける方を募集しています。
ぜひ採用サイトをご覧ください!
